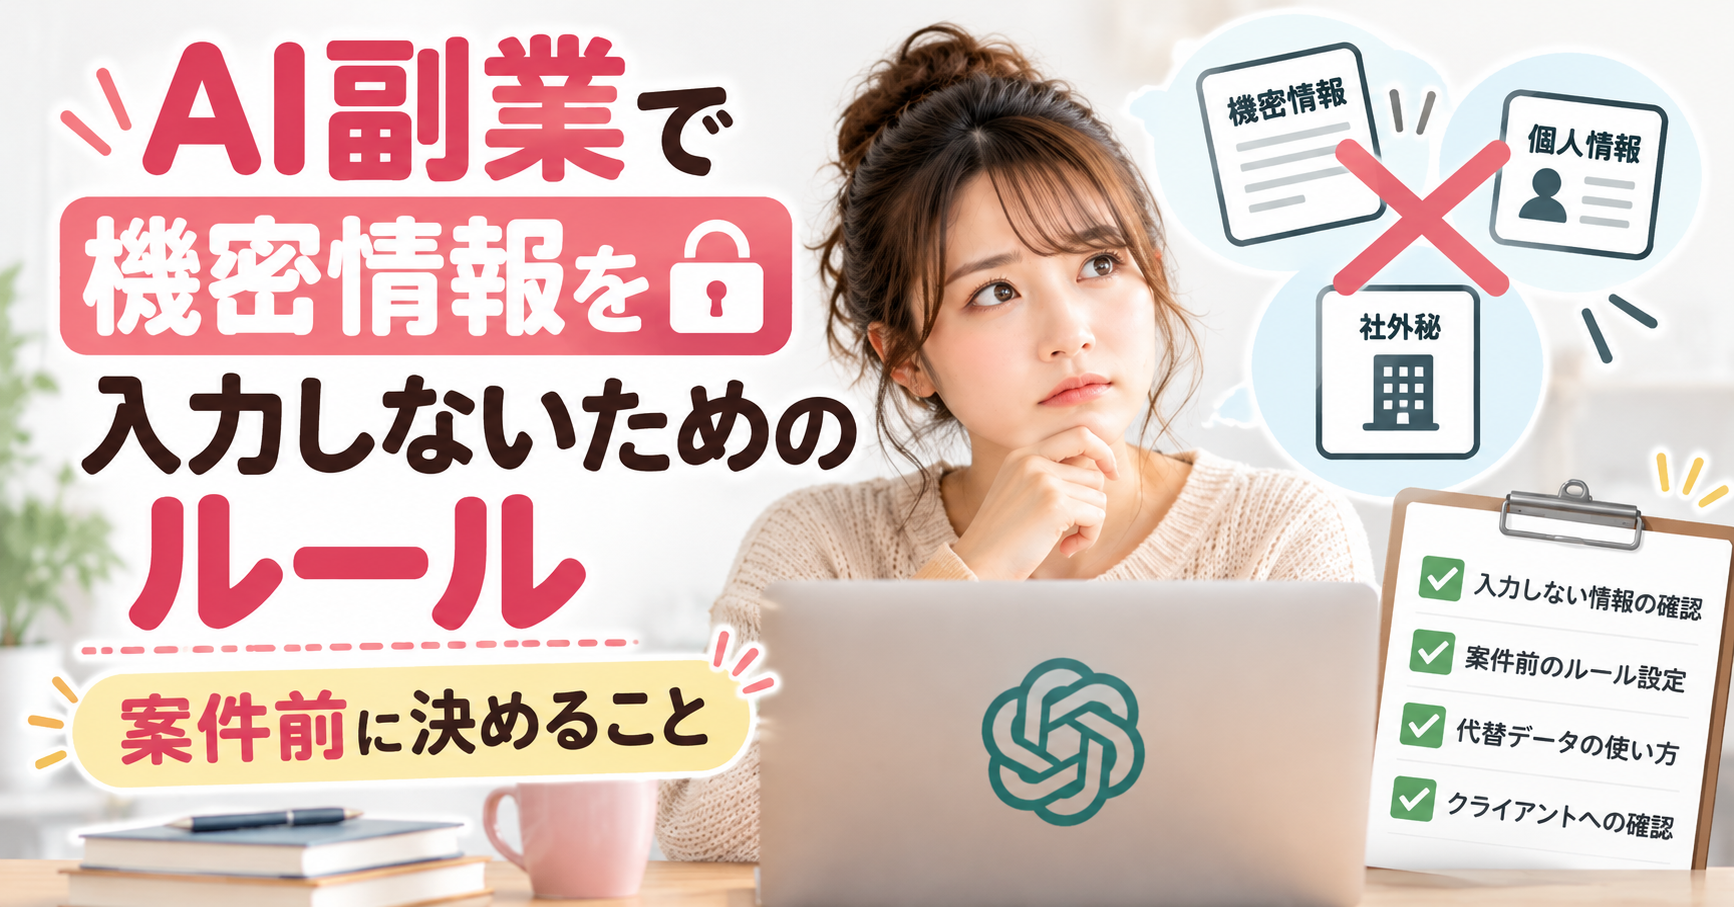
AI副業では、文章作成やデータ整理、要約、分析などに生成AIを使う機会が増えています。しかし、案件で受け取った資料をそのままAIへ入力すると、取引先の機密情報や個人情報まで外部サービスへ送信してしまうおそれがあります。
特に注意したいのは、「学習に使われない設定なら入力してよい」「名前を消せば問題ない」と自己判断しないことです。機密情報の扱いは、AIサービスの設定だけではなく、取引先との契約、案件ルール、入力する情報の種類まで含めて判断する必要があります。
AI副業では、案件を受けてから迷うのではなく、案件開始前に「何をAIへ入力してよいか」を決めておくことが重要です。この記事では、AI副業における機密データの入力ルールに絞って、実務で使いやすい形に整理します。
最初に決めておきたい原則
取引先から受け取った非公開情報は、「AIに入力してよい」と確認できるまでは入力しない運用にしておくと判断がぶれにくくなります。
AI副業では機密情報を入力しないルールを先に決める
AI副業で機密情報を守るには、個人の注意力だけに頼らないことが大切です。「これは大丈夫そう」と案件ごとに判断していると、納期を急いでいるときや大量の資料を処理するときに判断が甘くなりやすくなります。
経済産業省などによるAI事業者ガイドラインでも、AI利用者には、AIシステムやサービスへ機密情報などを不適切に入力しないよう注意することが求められています。
そのため、AI副業では最初から「入力禁止」「条件付き」「入力可能」の3段階に分けておくと運用しやすくなります。
| 区分 | 情報の例 | 基本的な扱い |
|---|---|---|
| 入力禁止 | 取引先の未公開資料、顧客情報、パスワード、APIキー、認証情報、未公開の売上・原価情報 | 原則としてAIへ送信しない |
| 条件付き | 社内文書、業務データ、匿名化した事例、非公開コード、案件固有の文章 | 契約・案件ルール・利用環境を確認して判断 |
| 入力可能 | 自分で作成した一般的な文章、公開済み情報、架空データ、一般的な質問 | 権利や案件ルールに問題がなければ利用しやすい |
この表は絶対的な分類ではありません。同じ情報でも、取引先との契約内容や利用するAI環境によって扱いが変わります。
判断できない情報は「条件付き」ではなく、一度「入力禁止」として止めるくらいのルールにしておくと、案件中の迷いを減らせます。
AI副業で入力しない機密データの具体例
「機密情報」という言葉だけでは範囲が広く、実際の案件では判断しにくいものです。AI副業では、情報の名称ではなく、「公開されていないか」「他人から預かった情報か」「漏れた場合に影響があるか」で考えると整理しやすくなります。
取引先から受け取った非公開資料
企画書、マニュアル、社内資料、議事録、商品資料、マーケティング資料など、取引先から案件遂行のために渡されたファイルは注意が必要です。
「文章を要約するだけ」「誤字を直すだけ」であっても、ファイルを生成AIへアップロードすれば、資料そのものを外部サービスへ送信することになります。
AIで処理したい目的が軽い作業でも、入力する情報の機密性まで軽くなるわけではありません。
そのまま入力しない例
- 取引先から受け取ったPDFを丸ごとアップロードする
- 社外秘の企画書を貼り付けて要約させる
- 公開前の商品情報を使って記事を書かせる
- 社内会議の議事録をそのまま整形させる
顧客や担当者を特定できる個人情報
氏名、住所、電話番号、メールアドレスなどが含まれる顧客データも、安易に生成AIへ入力しないようにします。
個人情報保護委員会は、事業者が生成AIへ個人情報を含むプロンプトを入力する場合、その利用が特定された利用目的を達成するために必要な範囲か確認するよう注意を促しています。
また、本人の同意なく個人データを入力する場合には、AIサービス側でそのデータが応答生成以外の目的に扱われる可能性についても確認が必要になります。
AI副業で顧客リストや問い合わせ履歴を扱う場合は、「名前を消したから大丈夫」と判断せず、他の情報から個人を特定できないかまで考えることが大切です。
パスワードやAPIキーなどの認証情報
パスワード、APIキー、アクセストークン、秘密鍵、データベース接続情報などは、AIへ入力しない情報として明確に分けておきます。
プログラミング案件では、エラー内容を生成AIへ相談するために設定ファイルやソースコードをコピーすることがあります。このとき、コード内やログ内に認証情報が残っているケースがあります。
認証情報はマスキング前提ではなく、送信しない運用を基本にします。
エラー相談をするときは、必要部分だけを切り出し、キーやトークン、接続先、顧客固有情報が含まれていないことを確認してから使用します。
未公開の売上・原価・戦略情報
売上データ、原価、利益率、広告実績、価格戦略、販売計画、新商品情報なども、案件によっては重要な機密情報になります。
データ分析の副業では、CSVやExcelファイルをAIへ読み込ませると簡単に分析できますが、便利だからといって実データをそのまま投入してよいとは限りません。
分析方法だけをAIに考えさせ、実データの処理は手元の環境で行う方法も選択肢になります。
非公開のソースコードや仕様書
プログラミングやシステム開発の副業では、ソースコード、設計書、API仕様、データベース構造などを扱うことがあります。
これらには、取引先独自の処理ロジックやシステム構成、脆弱性につながる情報が含まれる可能性があります。
コードレビューやエラー解決にAIを使う場合も、案件全体のコードを渡すのではなく、問題を再現できる最小限のサンプルへ置き換えられないかを先に検討します。
案件前に決める5つの機密データ運用ルール
AI副業で機密情報の入力事故を防ぐには、案件が始まる前に具体的なルールを決めておく必要があります。最低でも、次の5項目を確認しておくと実務で判断しやすくなります。
ルール①:利用できるAIサービスを決める
最初に決めるのは、「何を入力するか」だけではありません。どのAIサービス、どのアカウント、どの契約環境を利用してよいかも決めます。
同じサービス名でも、個人向け環境と法人向け環境、API利用などでデータの扱いや設定が異なる場合があります。
自分が普段使っている個人アカウントを、許可なく副業案件へ流用しないことを基本ルールにしておくと安全管理がしやすくなります。
- 案件でAI利用が許可されているか
- 指定されたAIサービスがあるか
- 個人アカウントを使ってよいか
- ファイルアップロードが許可されているか
- 外部サービスとの連携機能を使ってよいか
ルール②:入力禁止情報を案件ごとに決める
「機密情報は禁止」だけでは、実際の作業時に判断できません。案件で扱う資料を見ながら、具体的な入力禁止情報を決めます。
たとえばWebライティング案件なら、公開済みの商品情報は利用できても、公開前の記事構成、アクセス解析データ、クライアント独自のSEO資料は入力禁止という運用が考えられます。
案件ごとに「AIへ入れてはいけない具体例」を決めることが重要です。
ルール③:マスキングと抽象化の基準を決める
実データを使わずにAIへ相談できる場合は、固有情報を一般化します。
たとえば「株式会社ABCの月商は3,248万円」という実データを渡す必要がなければ、「あるEC企業の月次売上データ」のように置き換えます。
| 元の情報 | AIへ相談するときの置き換え例 |
|---|---|
| 株式会社ABC | 取引先A社 |
| 山田太郎 | 担当者A |
| 実際の顧客メール | 内容を一般化した架空の問い合わせ文 |
| 実売上3,248万円 | 架空の数値 |
| 実際のAPIキー | YOUR_API_KEY |
ただし、単純に会社名や氏名を削除しただけでは、案件内容や数値、役職、地域などを組み合わせて対象を推測できる場合があります。
マスキングは「名前を消す作業」ではなく、案件固有情報を必要最小限まで減らす作業として考えます。
ルール④:ファイルと外部連携の扱いを決める
生成AIでは、文章の貼り付けだけでなく、PDF、Excel、画像、音声、ソースコードなどを直接アップロードできます。
また、クラウドストレージやメール、社内データベースなどとAIを連携できるサービスもあります。
便利な一方で、入力範囲が広くなるほど「必要のない情報まで渡す」可能性も高くなります。
ファイル利用時の確認項目
- ファイル全体を送信する必要があるか
- 必要なページだけにできないか
- 個人情報やコメント欄が残っていないか
- 非表示シートやメタデータに情報が残っていないか
- 別の顧客情報が同じファイルに含まれていないか
「見えている部分だけ」ではなく、ファイル全体に何が含まれているか確認することがポイントです。
ルール⑤:誤入力したときの報告手順を決める
機密情報の運用では、「絶対にミスを起こさない」という前提だけでは不十分です。誤ってAIへ入力した場合に、誰へ報告し、何を確認するかも決めておきます。
個人で受ける副業案件でも、取引先への連絡窓口や報告方法を確認しておくと、発覚後に自己判断で対応するリスクを減らせます。
- 入力した情報の内容
- 入力した日時
- 利用したAIサービスとアカウント
- 文章貼り付けかファイル送信か
- 共有リンクなどを作成していないか
- 認証情報が含まれていないか
- 案件の連絡先や報告ルール
認証情報を送信してしまった場合は、履歴削除だけで終わらせず、利用している環境のルールに従ってキーやパスワードの変更が必要か検討します。
「学習されない設定」だけで入力可と判断しない
生成AIについて、「入力内容がAIの学習に使われない設定なら機密情報を入れても安全」と考えてしまうケースがあります。
しかし、AIサービスにおけるデータの扱いには、モデル学習だけでなく、サービス提供のための処理、保存期間、管理者による設定、外部機能との連携など複数の要素があります。
実際にAIサービスでは、個人向けプランと法人向けサービスでモデル改善へのデータ利用条件が異なる場合があります。
「学習に使われない」と「その案件の機密情報を入力してよい」は別の判断です。
AI側の設定で問題がなくても、取引先との秘密保持契約や業務委託契約、社内ルールなどで外部サービスへの送信が制限されていれば、その条件を優先して判断する必要があります。
次のような判断は避けましょう。
- 有料プランだから機密情報を入力してよい
- 学習オフだから何でも入力してよい
- 履歴を削除できるから問題ない
- 名前だけ消せば個人情報ではない
- 取引先からAI禁止と言われていないので使ってよい
AI副業の作業別に機密情報を守る方法
同じAI副業でも、ライティング、データ分析、プログラミングなどでは入力する情報が異なります。ここでは、実データをAIへ渡さずに作業する考え方を整理します。
ライティングや編集では文章の型だけ相談する
取引先から渡された原稿をそのままAIへ貼り付けるのではなく、文章構成や表現方法だけ相談できないか考えます。
たとえば、実際の商品発売前資料を渡す代わりに、「新商品の紹介記事で必要な構成を考えて」と依頼し、生成された型へ自分で情報を当てはめます。
AIに素材そのものを渡すのではなく、作業方法を聞くだけでも活用できる場面は多くあります。
データ分析では架空データで手順を作る
顧客データや売上表を分析したい場合、最初から実ファイルをAIへアップロードする必要はありません。
列名やデータ構造を一般化し、架空のサンプルデータを使って分析方法やExcel関数、Pythonコードなどを作らせる方法があります。
その後、実際の処理を許可されたローカル環境などで実行すれば、実データをAIへ送らずにAIの支援だけを利用できます。
プログラミングでは再現コードを作る
エラー解決のためにプロジェクト全体をAIへ渡すのではなく、問題が発生する箇所だけを抜き出して再現用コードを作ります。
変数名、サーバ名、URL、顧客ID、APIキーなども架空の値へ変更します。
「実際のコードを見せないと相談できない」と考える前に、問題の仕組みだけを再現できないか検討することが重要です。
AI副業を受ける前の機密情報チェックリスト
案件開始前に以下を確認しておくと、作業途中で「これはAIに入れてよいのか」と迷いにくくなります。
- この案件では生成AIを利用してよいか
- 使用できるAIサービスは決まっているか
- 個人アカウントを利用してよいか
- 取引先の非公開資料をAIへ入力してよいか
- 個人情報を扱う可能性があるか
- 入力禁止とする情報を具体的に決めたか
- マスキングや抽象化の基準を決めたか
- ファイルアップロードの可否を決めたか
- クラウドサービスとの連携機能を使ってよいか
- 誤入力した場合の報告先を確認したか
すべての案件で複雑な規程を作る必要はありません。
ただし、最低でも「利用できるAI」「入力禁止情報」「誤入力時の連絡先」の3点を決めておけば、機密データの扱いはかなり明確になります。
AIに機密情報を入力してしまったときの対応
誤入力に気付いた場合は、焦って履歴だけを消して終わらせず、まず何を送信したか整理します。
案件の情報管理ルールや取引先との契約によって必要な対応は変わるため、自分だけで「問題なし」と判断しないことが重要です。
- 追加の入力や共有を止める
- 入力した情報と日時を記録する
- 利用したAIサービスとアカウントを特定する
- 案件で指定された報告先へ連絡する
- 認証情報が含まれていれば変更の必要性を確認する
- 利用環境で可能な削除・共有停止などの措置を確認する
個人情報が含まれていた場合は、情報の内容や件数、利用状況によって確認事項が増える可能性があります。
誤入力後に重要なのは、隠すことではなく、事実関係を残して決められた手順で対応することです。
AI副業の機密情報入力でよくある質問
Q1. 会社名や氏名を消せばAIへ入力しても大丈夫ですか?
会社名や氏名を削除しただけで、必ず安全になるとは限りません。案件内容、数値、役職、地域など他の情報との組み合わせから対象を推測できる可能性があります。
固有名詞だけではなく、業務上必要のない具体情報まで削減できるか確認します。
Q2. AIの学習をオフにすれば取引先資料を入力できますか?
学習設定だけでは判断できません。AIサービス側のデータ取扱条件に加え、取引先との契約、秘密保持条件、案件ルールなども確認する必要があります。
案件として入力許可を確認できない場合は、非公開資料をそのまま送信しない運用が分かりやすいでしょう。
Q3. ChatGPTなどの有料プランなら機密情報を入力しても安全ですか?
有料であることだけを理由に、入力可能とは判断できません。サービスや契約形態によってデータ利用条件や管理機能が異なるためです。
料金プランではなく、実際に利用する環境のデータ取扱条件と案件側のルールを基準に判断します。
Q4. クライアントからAI禁止と言われていなければ使ってよいですか?
禁止されていないことと、機密情報を外部AIへ送信する許可があることは同じではありません。
非公開資料や顧客データを扱う案件では、AI利用の可否が不明なら、実データを入力しない方法で作業するほうが管理しやすくなります。
Q5. AIを使わずに機密データを扱うしかありませんか?
必ずしもそうではありません。実データを渡さず、架空データ、一般化した文章、再現コードなどを使って、作業方法だけAIに相談できる場合があります。
AIへ何を渡すかを減らしながら、構成作成、分析手順、関数、コード例などの支援を受ける方法を検討できます。
Q6. 機密情報を誤ってAIへ入力したら履歴を削除すれば終わりですか?
履歴削除だけで対応が完了するとは限りません。送信した情報の種類、利用したサービス、共有状態、案件の契約条件などを確認する必要があります。
認証情報が含まれていれば変更が必要になる場合もあるため、案件で定められた報告手順に沿って対応します。
AI副業では案件前に機密情報の入力範囲を決めておこう
AI副業で機密情報を守るために重要なのは、「AIを使わないこと」ではなく、どの情報を、どの環境へ、どの条件で入力できるのかを事前に決めることです。
特に、取引先の非公開資料、個人情報、認証情報、未公開の売上や戦略情報、非公開コードなどは、作業を効率化したいという理由だけで生成AIへ入力しないようにします。必要であれば、架空データや抽象化した情報へ置き換えてAIの支援を受ける方法を検討できます。
案件開始前に「利用できるAI」「入力禁止情報」「マスキング基準」「ファイル利用」「誤入力時の対応」を決めておけば、作業中の判断がぶれにくくなります。AI副業では、便利さより先に機密データの運用ルールを決めておくことが重要です。